OPENING MANGA / 3 PAGES
細かく書いた。でも、伝わらない。
条件を増やしたのに、見せたかった場面が小さい。そこを直すつもりが、気に入っていた構図まで変わってしまう。私が実際にやらかした失敗を、白峰レンに演じてもらいました。
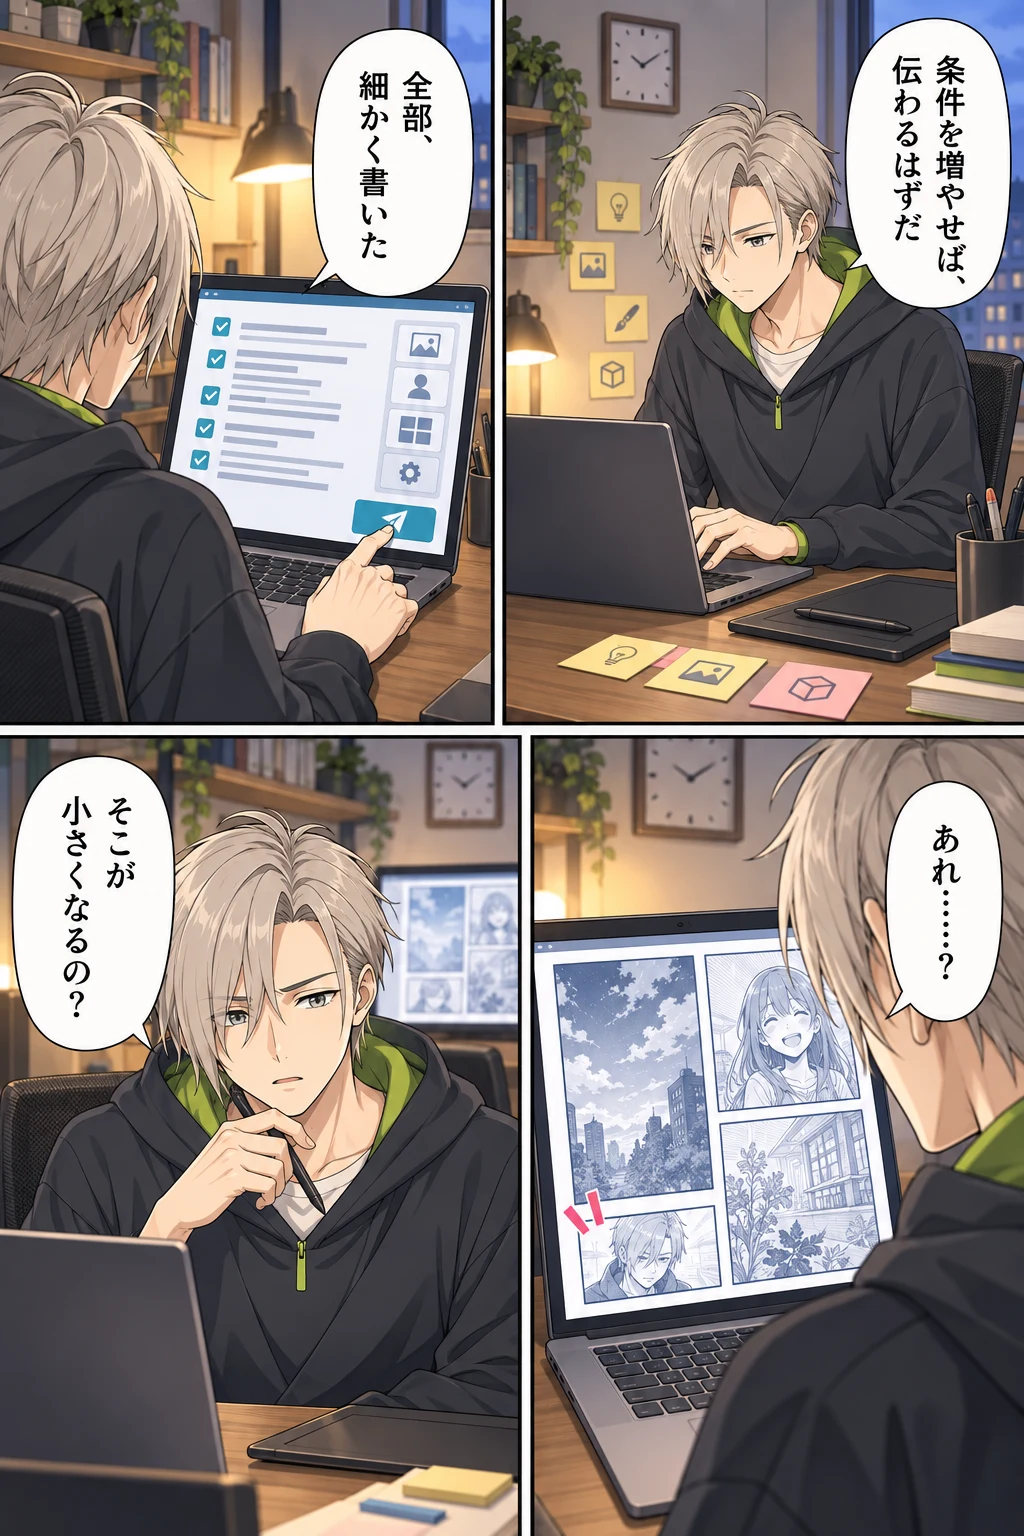
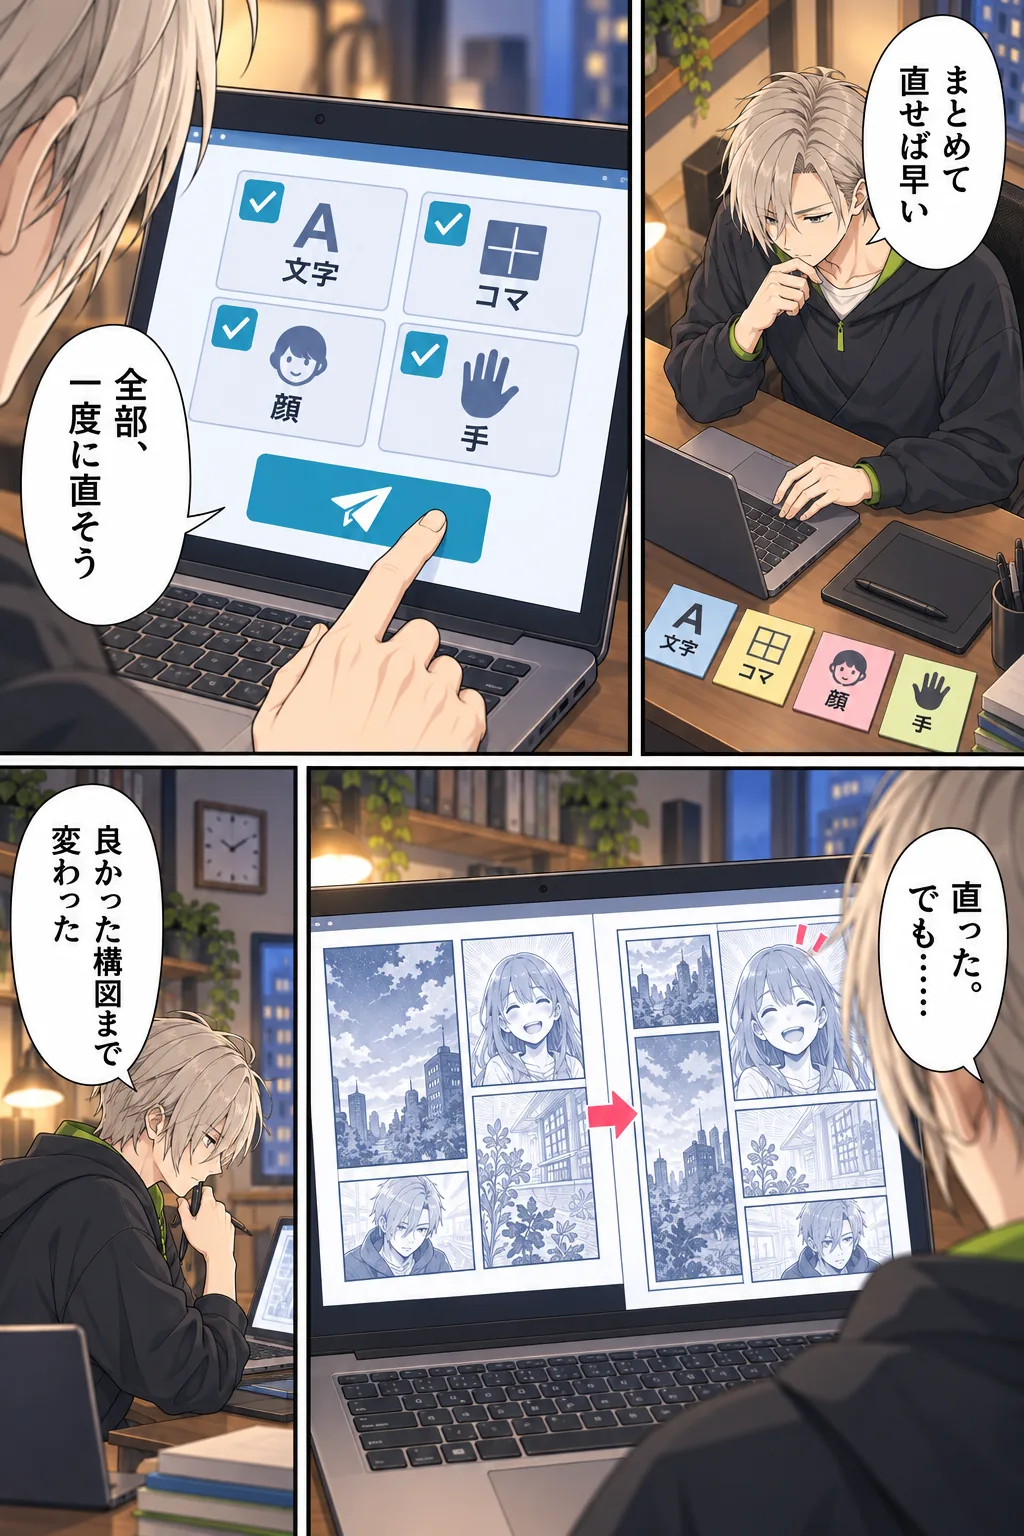
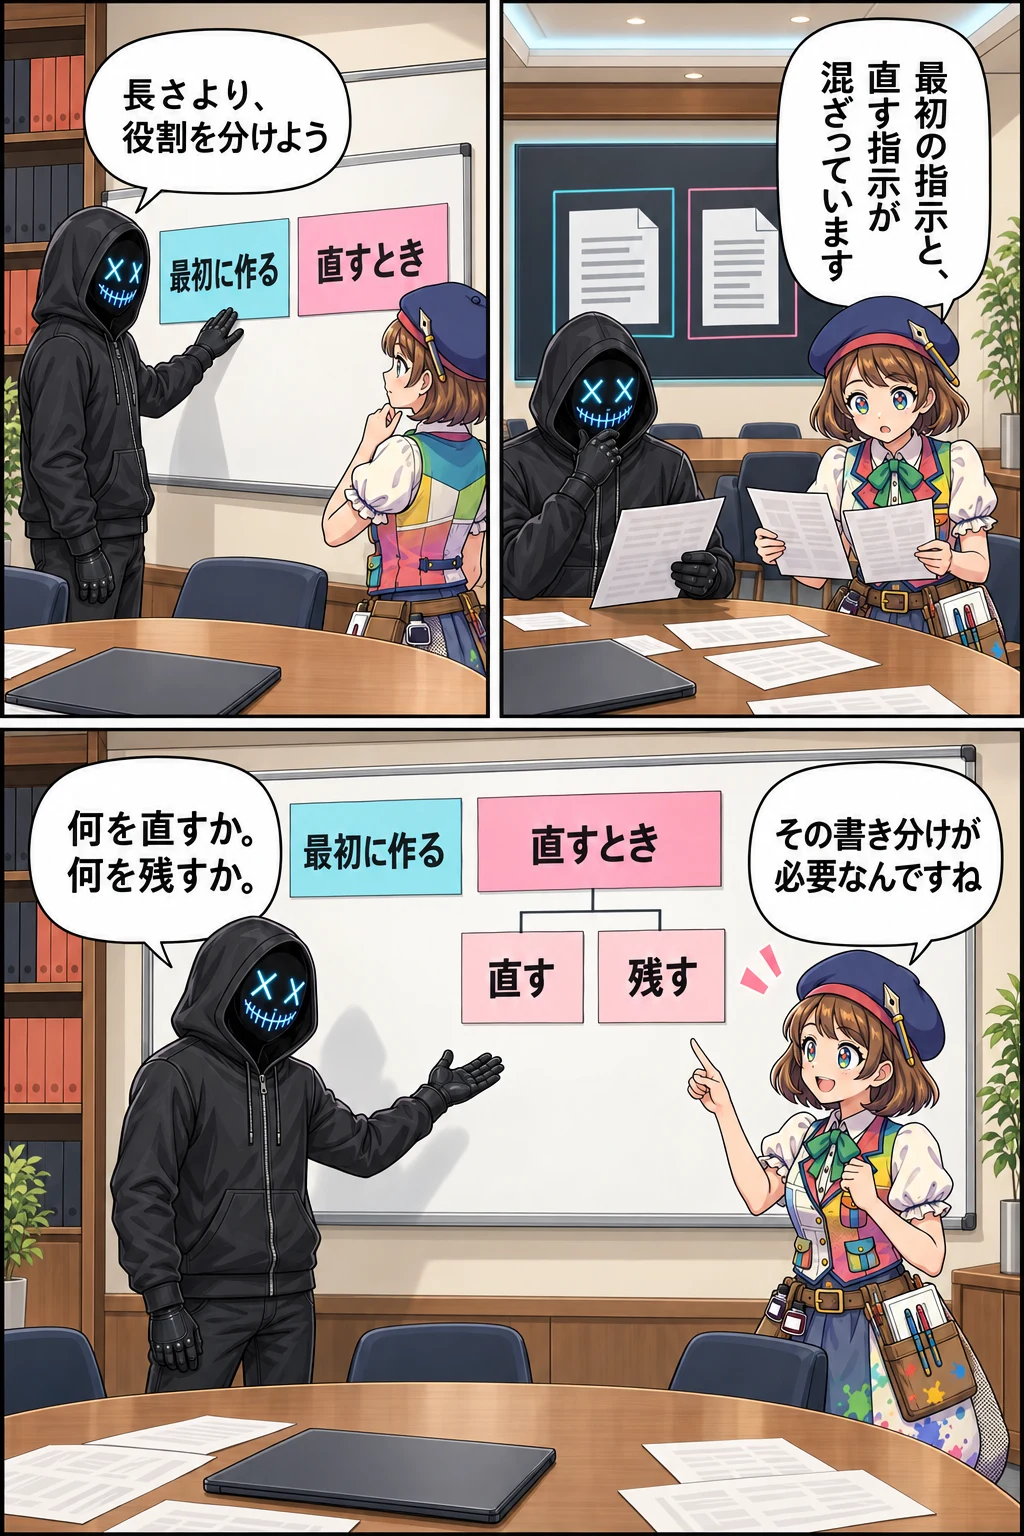
指示はこんなに細かく書いたのに、いちばん見せたい場面が小さい。文字を直したかっただけなのに、気に入っていた構図まで変わっている。そこで文字、顔、手、コマ割りをまとめて直したら、さらに崩れた。
これ、ChatGPTでAI漫画を作っていると本当に起きます。私も何度かやりました。指示が短いから失敗するのではありません。このページで何を伝えたいのか。何を優先するのか。どこを直して、どこを絶対に残すのか。これが一緒くたになると、指示が長くても伝わりません。
私はChatGPTで画像を生成し、自分専用のAI漫画制作ハーネスも使っています。それでも、目的や人物資料、世界観、コマの役割、セリフを先に整理するのは私です。出てきた画像も、1ページずつ自分の目で確かめます。自動で進められるところは増えましたが、お任せで完成、とはいきません。
今回は、AI漫画の作り方全部ではなく、1ページ分の制作指示と、生成した後の直し方に絞って話します。実際にこの記事の漫画で使った指示と、失敗した2ページ目を直した指示も、そのままお見せします。
30秒で分かる結論
最初に作る指示目的・資料・コマ・文字・固定条件
→直すときの指示直す・残す・入れないを分ける
長さより、役割と優先順位をそろえる。先に答えを言うと、1ページ漫画の指示は、長さではなく「何を先に決め、何を分けて書くか」で変わります。私が実際にやっている順番は、次の通りです。
- ページの目的と役割を決める
- 出力仕様と読む順番を決める
- 人物・衣装・世界観の参照資料をそろえる
- コマごとの出来事、感情、カメラ位置、セリフを書く
- 維持するもの、変えてよいもの、入れてはいけないものを分ける
- 生成後は、現在の最良画像を保存してから一項目ずつ直す
直すときも、「ここが駄目」だけでは終わらせません。どの場所を、どう変えて、どこはそのまま残すのかまで書きます。
それでも3回直して改善しなければ、その画像にこだわるのをやめます。最初から生成し直すか、新しいセッションへ移った方がうまくいくことが多いからです。
プロンプト設計は、長い文章を書くことではない
条件を思いついた順に追加すると、文章はどんどん長くなります。でも、長く書けば書くほど正確に伝わる、とは限らないんですよね。
例えば、次の条件をひとつの段落にまとめていたら、どれがいちばん大事なのか見えにくくなります。
- 誰に読んでもらうページなのか
- 何コマで、どの順番に読むのか
- 誰が登場するのか
- どのセリフを誰が話すのか
- 何を必ず維持するのか
- 何を変えてよいのか
そのまま修正を重ねると、後から足した条件ばかりが強くなって、最初に大事だった目的や構図が埋もれていきます。「文字を直したかっただけなのに、構図まで変わった」というのは、このパターンです。
私が「プロンプトを設計する」と言っているのは、難しい文章を書くことではありません。目的、優先順位、変えてよい範囲を分けて、AIが迷わない順番に並べることです。
 コミコ
条件を全部書けば、その分だけ正確になると思っていました。
 親バカ社長
条件の数より、「何を最優先するか」が分かることの方が大切です。ページの目的と、絶対に変えないものが同じ重さで埋もれていたら、長くても判断できません。
企画から仕上げまでの流れも先に知りたい方は、AI漫画の作り方ガイドから読んでください。「とりあえず1ページをどう指示するの?」と困っている方は、このまま先へ進んで大丈夫です。
1ページ制作指示書は、11項目に分ける
DIAGRAM 01 / INSTRUCTION ORDER
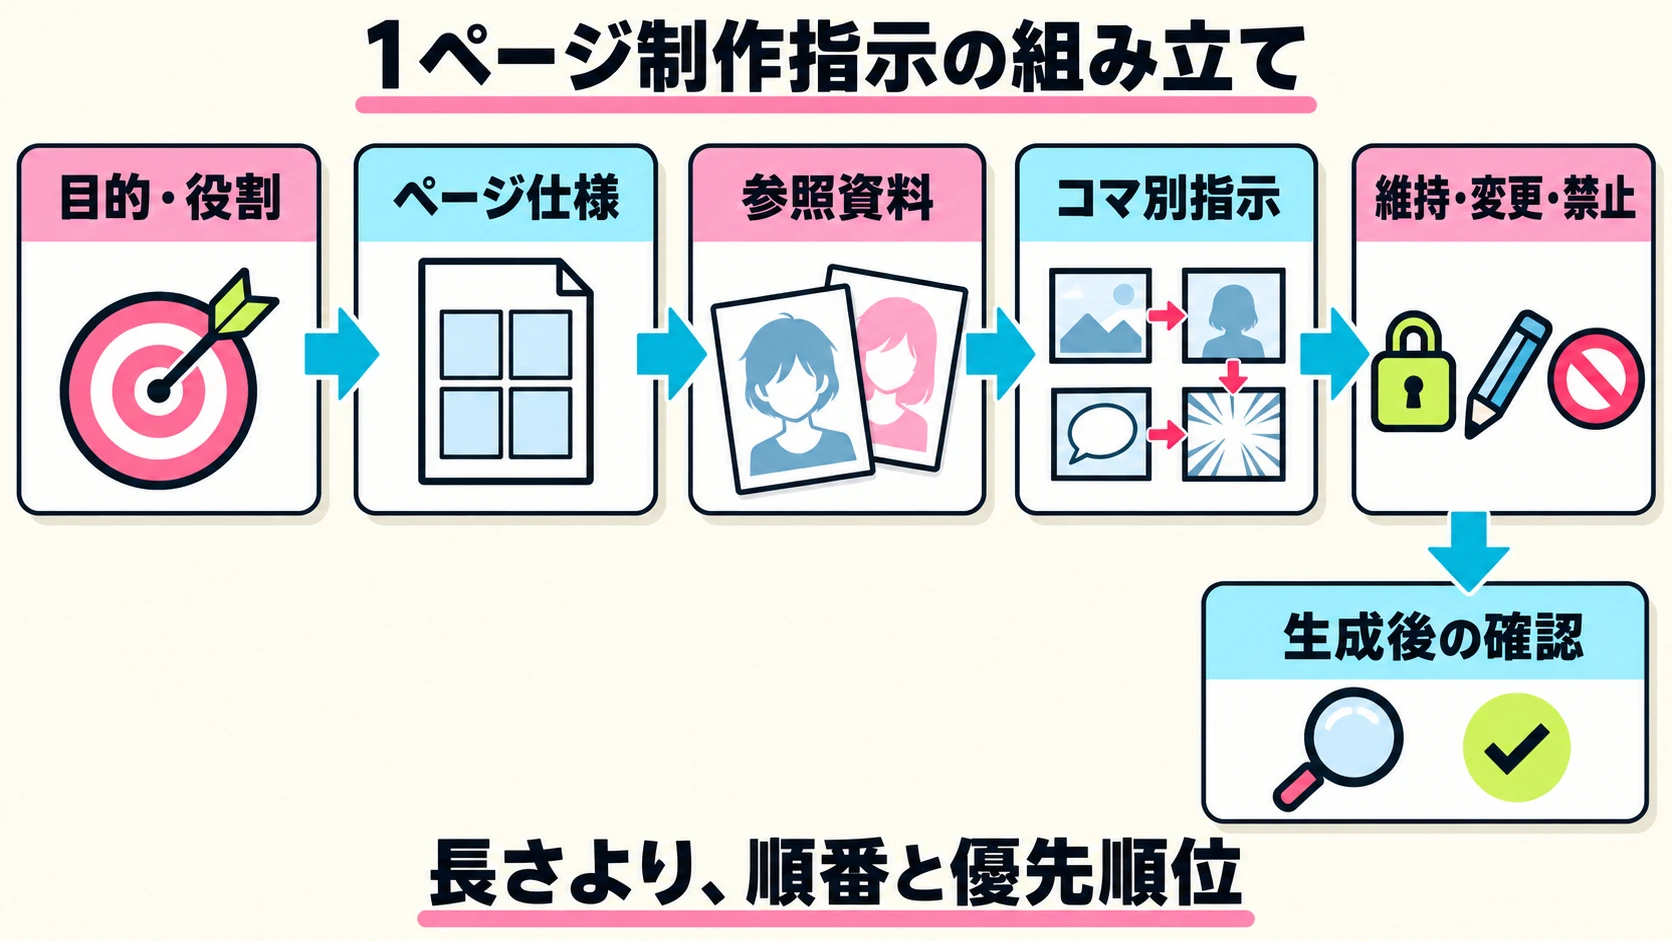
私が今回の記事漫画を作ったときは、次の11項目を上から順番に埋めていきました。
| 順番 | 項目 | 書く内容 |
|---|---|---|
| 1 | ページの目的 | 読者に何を感じ、何へ気づいてもらうか |
| 2 | ページの役割 | 問題提起、悪化、原因整理など、前後の中で担う仕事 |
| 3 | 出力仕様 | 画像サイズ、縦横比、コマ数、日本漫画の読む順番 |
| 4 | 人物資料 | 三面図、衣装表、表情表、小道具や衣装の詳細 |
| 5 | 世界観資料 | 場所、時間、光、色、家具、道具、空間のルール |
| 6 | コマごとの場面 | 人物、動作、感情、カメラ位置、前後のつながり |
| 7 | セリフ | 話者、文言、吹き出しの位置、尻尾の向き |
| 8 | 維持するもの | 顔、髪、衣装、人物位置、背景、良かった構図など |
| 9 | 変えてよいもの | 表情の強さ、手の位置、小物の角度など |
| 10 | 入れないもの | 人物追加、不要な文字、コマ数変更、左右反転など |
| 11 | 生成後の確認 | 読み順、文字、人物、身体、背景、見切れなど |
11項目すべてを、毎回同じ文字数で書く必要はありません。場面の説明は短くても、人物や背景の固定条件が多いページもあります。ただ、「何を変えてよいか」を後から読み返しても分かるように、場面と固定条件は混ぜないようにしています。
この冒頭漫画では、ページごとに役割を変えた
今回の冒頭漫画は3ページで作りました。同じ失敗を3回繰り返すのではなく、1ページごとに見せるものを変えています。
| ページ | 役割 | 描く出来事 | 本文へ残すこと |
|---|---|---|---|
| 1 | 指示の問題を見せる | 白峰レンが条件を増やすが、ページの目的と優先順位が曖昧なため、重要な場面が小さくなる | 制作指示の項目と順番 |
| 2 | 修正方法の問題を見せる | 文字、コマ数、顔、手を一度に直そうとして、良かった構図まで変わる | 一回の修正で扱う単位 |
| 3 | 原因を整理する | 研究所で「最初の制作指示」と「生成後の修正指示」が混ざっていたと整理する | 具体的な記入方法と判断手順 |
白峰レンに失敗役を任せたのは、細部へこだわって条件を増やすほど、いちばん大事なことを見失ってしまう役に合っていたからです。3ページ目で私とコミコが登場し、どこで指示が混ざったのかを整理します。
参照画像は、優先順位を付けずに必要なものをそろえる
私は「三面図があれば、衣装表や世界観資料は後でいい」とは考えていません。そのページに必要な資料は、最初の生成からまとめて渡します。
- 三面図
- その場面の役柄衣装表
- 表情表
- 小道具の資料
- 衣装や装飾で形を守りたい部分の拡大表
- 場所、光、色、家具を示す世界観資料
主要キャラクターは、三面図と衣装表だけで終わらせません。表情に特徴があれば表情表、小道具や衣装にこだわりがあれば、そこを大きく見られる資料も作ります。優先順位を付けるというより、その人物と場面を描くために必要な資料は、全部必要という考え方です。
修正するときも、直したい画像だけを渡すのではなく、最初に使った人物資料をもう一度添えます。衣装、表情、小道具、背景を直すなら、それに関係する資料も一緒に渡します。
実際の1ページ目で渡したのは、白峰レンの三面図、役柄衣装表、表情表、固定ポーズ表の4点です。3ページ目は研究所へ場面が変わるので、私とコミコの三面図・表情資料に、研究所の世界観資料を加えた5点を渡しました。
「何枚あれば必ず同じ人物になるの?」と聞きたくなるところですが、ここは枚数だけでは決まりません。そのページに誰が出るのか、衣装や小道具にどこまで特徴があるのかで、必要な資料は変わります。私は枚数を先に決めるのではなく、そのページを描くために必要な資料を先に洗い出しています。
三面図や表情表に何を入れるかは、AI漫画のキャラクターを固定する方法で具体的に紹介しています。
コマごとの指示は、出来事と見せ方を分ける
「パソコンの前で困っている男性」とだけ書いても、私が頭の中で想像しているコマまでは伝わりません。どこから見るのか、人物はどちらを向くのか、視線と吹き出しをどこへ置くのか。ここを書かなければ、AIが決める部分になります。
コマごとの表には、少なくとも次を分けて書きます。
| コマ | 出来事 | 人物・動作 | 感情 | カメラ位置 | セリフ・文字 |
|---|---|---|---|---|---|
| 1 | 制作条件を追加している | 白峰レンが端末を見ながら入力する | まだ自信がある | 机の右斜め前から | 「条件を増やせば伝わるはずだ」 |
| 2 | 長い指示を送信する | 画面を見つめ、結果を待つ | 期待 | 肩越しに画面も見せる | 長文が増えたことだけ分かる画面 |
| 3 | 出力のズレに気づく | 重要な場面が小さい漫画を見る | 困惑 | 人物と端末を同時に見せる | 「そこが小さくなるの?」 |
これが、1ページ目を生成する前に作った整理表です。画像ができたら、この表と並べて、コマ数、セリフ、構図が指示通りかを見ていきます。
同じ場所が続くなら、「同じ部屋」だけで終わらせず、机、椅子、窓、時計、棚、照明、人物の位置まで書きます。生成した後に、「部屋は似ているけど、窓は反対側に移っている」と気づけるからです。
セリフは、現在は画像生成時から入れている
最初の頃は、絵だけ生成して、セリフは後から組む方法も試しました。でも、後から文字を載せると、吹き出しと表情、視線、コマの余白がばらばらに見えることが多かったんです。
今は、ChatGPTへ最初の画像生成を頼む段階からセリフを入れています。絵とセリフを一緒に渡した方が、人物の表情、視線、吹き出し、余白までひとつのコマとしてまとまりやすいと感じているからです。
- 誰が話すか
- 正確な文言
- どのコマに入れるか
- 吹き出しを置く範囲
- 尻尾をどの人物へ向けるか
- 日本漫画の読む順番で、何番目に読むか
ここまでを最初の制作指示に入れます。誤字や吹き出しの向きを直すときも、今は手作業で組み直さず、基本的にChatGPTへ修正を頼んでいます。
もちろん、最初から入れても誤字は出ますし、吹き出しの尻尾が別の人物へ向くこともあります。だから生成後は、文言、話している人、読む順番、文字サイズ、吹き出しの向きまで自分の目で見ています。
実際に使用した初回プロンプトを分解する
ここからは、この記事の冒頭漫画1ページ目を作ったとき、ChatGPTへ実際に送った指示をお見せします。添付画像の保存場所など、私の制作環境にしか関係しない部分だけは外しました。それ以外は、添付画像の役割も含めて実際の指示のままです。
Use case: illustration-story
Asset type: Japanese vertical manga page for the opening of a business column
Primary request: Create page 1 of a 3-page manga about an earnest young creator who writes a very detailed AI-manga instruction but loses the priority of what the page should communicate. This page must show the problem only; do not solve it.

Input images and roles:
- Image 1: canonical three-view identity reference for Shiramine Ren. Preserve his exact champagne-platinum asymmetric short hair with the right ear exposed, slim 177cm build, pale skin, slightly hunched posture, youthful adult face.
- Image 2: canonical role-outfit sheet. Use the LEFT casual creator outfit: graphite/dark charcoal jacket or hoodie, white inner shirt, black slim pants, black shoes, tiny acid-lime accents. Do not use the business suit.
- Image 3: canonical expression sheet. Use confident concentration first, then quiet confusion.
- Image 4: canonical pose sheet. Use natural tablet/laptop work poses and restrained gestures.

Output and reading order:
- Exactly 1024x1536 portrait composition.
- Exactly 4 manga panels with clear black gutters.
- Japanese manga reading order: top-right -> top-left -> bottom-right -> bottom-left. Visual gaze, action and speech balloons must follow that order.
- Polished contemporary Japanese business-manga style, clean ink, soft cel color, warm cream paper, restrained cyan and pink accent graphics. Professional, not chibi.

Continuous scene/background:
- One compact freelance creator's workroom in early evening.
- Large medium-brown wooden desk, black ergonomic chair, open dark laptop centered on desk, pen tablet on Ren's right, small square analog clock on back wall, narrow window on the RIGHT wall with pale blue evening light, one shelf on the LEFT wall, warm desk lamp on the left rear corner.
- Keep these room anchors consistent in all four panels so page 2 can continue the same scene.

Panel plan:
1) TOP-RIGHT, medium side shot. Ren leans toward the laptop and carefully types. Several neatly sorted sticky notes around the laptop use only simple icons, not tiny sentences. His expression is focused and quietly confident. Speech balloon, exact Japanese: 「条件を増やせば、伝わるはずだ」
2) TOP-LEFT, over-shoulder shot. The laptop shows a long structured instruction as clean abstract blocks and check marks; do not render unreadable paragraphs. Ren presses the send button. Small speech balloon, exact Japanese: 「全部、細かく書いた」
3) BOTTOM-RIGHT, close view of laptop and Ren's profile. The generated manga preview looks polished, but the emotionally important scene is visibly squeezed into the smallest panel while decorative panels dominate. Use visual hierarchy only; no tiny screen text. Ren notices the mismatch. Small balloon, exact Japanese: 「あれ……?」
4) BOTTOM-LEFT, close-up of Ren with quiet confusion, one hand hovering over the tablet. The monitor remains behind him with the tiny important panel visible. Speech balloon, exact Japanese: 「そこが小さくなるの?」

Text and speech balloons:
- Render the four quoted Japanese lines verbatim, once each, with no extra dialogue, captions, labels, sound effects, English, logos, watermark, or page number.
- Each balloon tail must point only to Ren in its panel.
- Use large readable Japanese lettering and generous margins; no text near trim edges.

Must preserve:
- Ren is the only person on this page.
- Same face, hair, outfit, desk, chair, laptop, window, shelf, clock and lamp across panels.
- Natural hands: exactly five fingers when visible; no duplicated arms; laptop screen faces Ren; tablet is held or placed naturally.

Do not add:
- No Oyabaka CEO, no Comico, no other people, no research laboratory, no solution, no universal prompt, no extra objects, no fantasy effects.
- Do not reverse the reading order. Do not change panel count.
「長っ」と思いました? でも、これは条件を思いついた順に詰め込んだ長文ではありません。「このページの仕事」「添付資料の役割」「出力仕様」「コマ別の出来事」「文字」「維持するもの」「追加しないもの」に分けています。生成後に、どの指示が守られていないかをひとつずつ照らし合わせるためです。
上から順に見ると、次の9つに分かれています。
- このページの目的と役割
- 出力サイズ、コマ数、右から左の読む順番
- 添付した参照画像それぞれの役割
- コマごとの時間、人物、動作、感情、カメラ位置
- セリフの正確な文言、話者、読む順番
- ページ内で維持する人物・背景・小物
- 変えてよい範囲
- 追加しない人物・文字・装飾
- 生成後に確認する項目
この文章をそのまま貼っても、あなたが作りたい1ページにはなりません。白峰レンの資料も、仕事部屋も、このページで起こる出来事も、今回の漫画専用だからです。コピーしてほしいのは文面ではなく、目的、資料、仕様、コマ、文字、維持、禁止に分ける順番です。
実例|「同じ場所を維持」で、構図まで同じになった
そして実は、この記事の漫画を作っている真っ最中に、まさに「何を残して、何を変えるか」の分け方で失敗しました。
できあがった2ページ目を私が見て、最初に浮かんだのがこの疑問です。
1ページ目と2ページ目は、あえて同じコマ割り、同じ構図にしているの?
答えは、いいえ。狙った演出ではありません。「同じ人物と同じ仕事部屋を維持する」と強く指示した結果、コマ割りとカメラ位置まで似たページになってしまいました。
最初の2ページ目を作るとき、私がまとめて渡したのは次の条件です。
- 1ページ目の採用画像と、白峰レンの三面図、衣装表、表情表、固定ポーズ表を参照する
- 白峰レンの顔、髪、衣装を維持する
- 同じ仕事部屋、机、窓、時計、棚、照明を続ける
- 4コマで、文字・コマ・顔・手をまとめて直す場面を描く
- 「まとめて直せば早い」から「良かった構図まで変わった」までの4つのセリフを入れる
人物と部屋の連続はしっかり書いています。その一方で、2ページ目でどの構図を変えるのか、1ページ目からどの構図を引き継がないのかを書いていませんでした。
結果、右上が人物、左上が端末、右下が端末、左下が人物という割り方まで、1ページ目と似てしまいました。中で起きている失敗は別なのに、続けて読むと同じページをもう一度見せられているように見えます。連続させたいのは人物と部屋。変えたいのはコマの大小とカメラ位置。ここを混ぜたのが原因です。
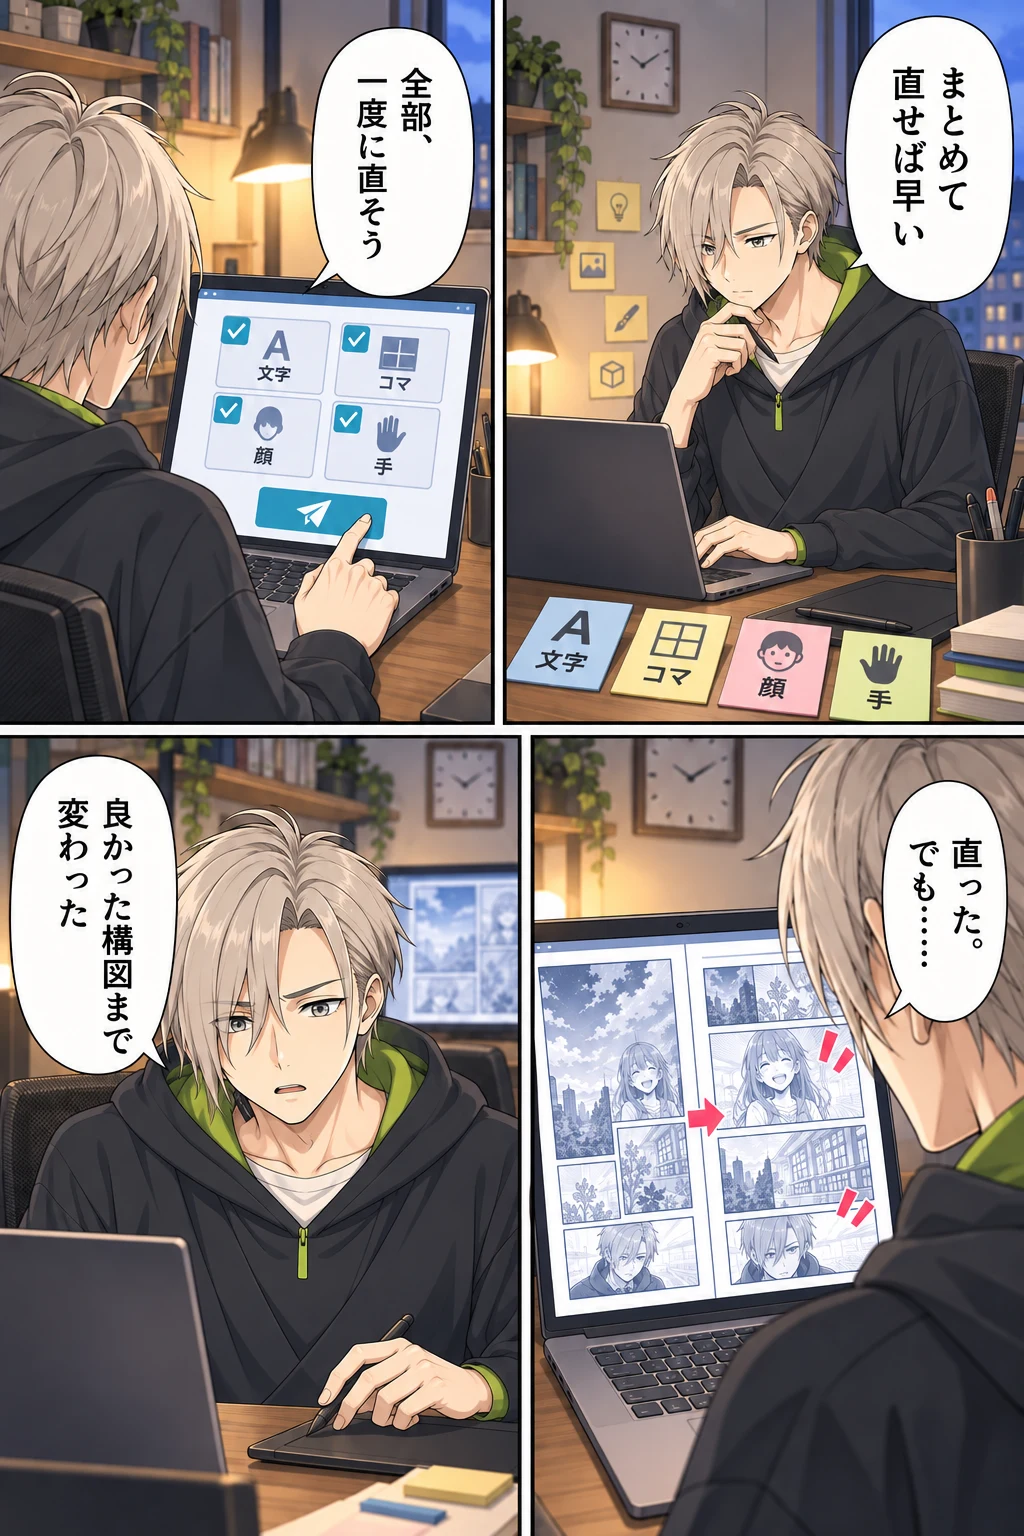
「AIが変な画像を出した」で終わらせるのは簡単です。でも、この失敗は私の指示にも原因がありました。1ページ目を参照に渡して「場所は維持する」と書いたのに、「コマ割りとカメラ位置は引き継がない」を書いていなかったんです。
実際に使用した2ページ目の修正プロンプト
そこで次は、直す対象を「コマの大小、カメラ位置、人物と端末の配置」だけに絞りました。その上で、「残すもの」と「引き継がないもの」を分けて書きました。これが、修正版を作ったときに実際に送った指示です。
Use case: illustration-story
Asset type: 親バカ社長HPコラムの冒頭漫画・第2ページ(修正版)
Primary request: 添付した旧2ページ目は、1ページ目と4コマの割り方・カメラ位置・人物の見せ方がほぼ同じになり、ページ固有の「複数箇所をまとめて直したため、良かった構図まで崩れた」という悪化が視覚的に弱くなった。物語、人物、仕事部屋、4つのセリフは維持し、コマの大小とカメラ位置だけを明確に作り直す。

Input images and roles:
- Image 1: 採用済み1ページ目。白峰レンの人物同一性、カジュアル衣装、夕方の仕事部屋、机・椅子・窓・時計・棚・照明・端末の連続性を参照する。コマ割りとカメラ位置はコピーしない。
- Image 2: 不採用になった旧2ページ目。4枚の修正カード、修正結果の内容、4つのセリフだけを参照する。均等な2×2グリッド、右上正面→左上肩越し→右下端末→左下正面という撮影順は引き継がない。
- Image 3: 白峰レンの正規三面図。顔、右耳を出すシャンパンプラチナの非対称ショート、非常に細身で少し猫背の成人男性という同一性を維持する。
- Image 4: 役柄衣装表。左側のカジュアル制作者衣装を使用する。グラファイトのパーカまたはジャケット、白いインナー、黒い細身パンツ、少量のアシッドライム。ビジネススーツを使わない。
- Image 5: 表情表。最初は早く直せると思う集中、結果を見た後は静かな焦りと落胆を使う。

Output and reading order:
- 1024×1536pxの縦長漫画ページ。
- 4コマ。日本漫画の右から左、上から下へ読む順番を明確にする。
- 1ページ目と同じ均等な2×2グリッドにしない。上下とも左右の幅を変え、下段右の「崩れた修正結果」をページ内で最も大きなコマにする。
- 太く明瞭な黒いコマ枠と十分な余白。

Panel layout and camera plan:
1) 右上。幅の狭い縦長コマ。机を右斜め上から見下ろす俯瞰。白峰レンの手元、端末、机上の4枚のカード「文字」「コマ」「顔」「手」を見せる。顔は小さくてよい。セリフは正確に「まとめて直せば早い」
2) 左上。右上より幅の広い横長コマ。送信操作をする指先と、端末上で4項目すべてが選択されている状態の極端なクローズアップ。白峰レンの目元または横顔を画面端に少しだけ入れる。セリフは正確に「全部、一度に直そう」
3) 右下。ページ内で最大の横長コマ。端末の修正前後比較を主役にする。文字・顔・手の一部は直っているが、もともと良かった人物の配置、視線、コマの大小、余白のリズムまで変わってしまったことが一目で分かる。白峰レンは肩越しの小さな後ろ姿だけ。セリフは正確に「直った。でも……」
4) 左下。幅の狭い縦長コマ。机の横からの広めのサイドショット。白峰レンと端末画面を同じコマへ入れ、レンがペンを止めて静かに落胆する。正面顔のアップにしない。セリフは正確に「良かった構図まで変わった」

Text and speech balloons:
- 上記4つの日本語だけを、それぞれ1回ずつ正確に描く。
- 追加の説明文、擬音、英語、ロゴ、透かし、ページ番号を入れない。
- 吹き出しの尻尾は各コマの白峰レンだけへ向ける。端末や別の場所へ向けない。
- スマホ表示でも読める大きな文字。端から十分に離す。

Must preserve:
- 白峰レンは1人だけ。同じ顔、髪、体格、衣装を全コマで維持する。
- Image 1の仕事部屋を維持する。右壁の細い窓、左壁の棚、背面の四角い時計、木の机、黒い椅子、左奥の暖色デスクライト、暗色のノートPC、ペンタブレット。
- 夕方から夜へ少し進んだ自然な時間経過。
- 自然な手指。見える手は5本指、腕を増やさない。端末画面はレン側を向ける。
- 大人向けのポップ・ビジネス漫画スタイル。明瞭な線、柔らかなセル塗り、生成りの紙、シアンとピンクの控えめなアクセント。

Change only:
- コマの大小、カメラ位置、人物と端末の画面内配置。
- 2ページ目固有の「まとめて直した結果、構図まで崩れた」という悪化が視覚的に伝わる見せ方。

Do not add or copy:
- 1ページ目と同じ均等な2×2コマ割りをコピーしない。
- 1ページ目と同じ4つのカメラ位置を同じ順番で繰り返さない。
- 親バカ社長、コミコ、別の人物、研究所を入れない。
- 万能プロンプトや解決策を示さない。
- 人物の顔、髪、衣装、部屋の基本配置、指定セリフを変えない。
修正後は、4つのセリフ、白峰レン、仕事部屋はそのまま。上下のコマ幅とカメラ位置だけが変わりました。下段右には、端末上の修正前後をいちばん大きく見せるコマを置いています。左下は正面顔のアップをやめて、白峰レンと端末画面を横から一緒に見せました。これで、2ページ目にしかない「直したら、良かった構図まで崩れた」という失敗が見えるようになりました。
今回は、この指示で1回目の再生成から採用できました。もちろん、毎回1回で直るわけではありません。それでも今回は、直す範囲を絞って、残すものをはっきり書いたことで、狙っていた修正ができました。失敗した旧画像も消さず、どの指示で何が変わったのかを履歴に残しています。
生成後は、問題を一つ選んで修正する
私が「一度に一つずつ直す」のは、その方が修正後の変化を追いやすいからです。OpenAIの公式資料でも、画像を編集するときは、変える内容と残す内容を分け、一項目ずつ調整して確認する方法が案内されています。会話を続けながら画像を直せても、触っていない部分まで変わることはあります。だからこそ、直す箇所だけでなく、残す箇所も毎回書きます。
私が実際に直すときの順番は、次の通りです。
- 現在の最良画像を保存する
- 実際に起きている問題を列挙する
- 今回直す一項目を選ぶ
- 望む状態を具体的に書く
- 維持する人物、構図、背景、文字を書く
- 変更してはいけないものを書く
- 修正前後を比較し、結果を記録する
DIAGRAM 02 / REPAIR STRUCTURE
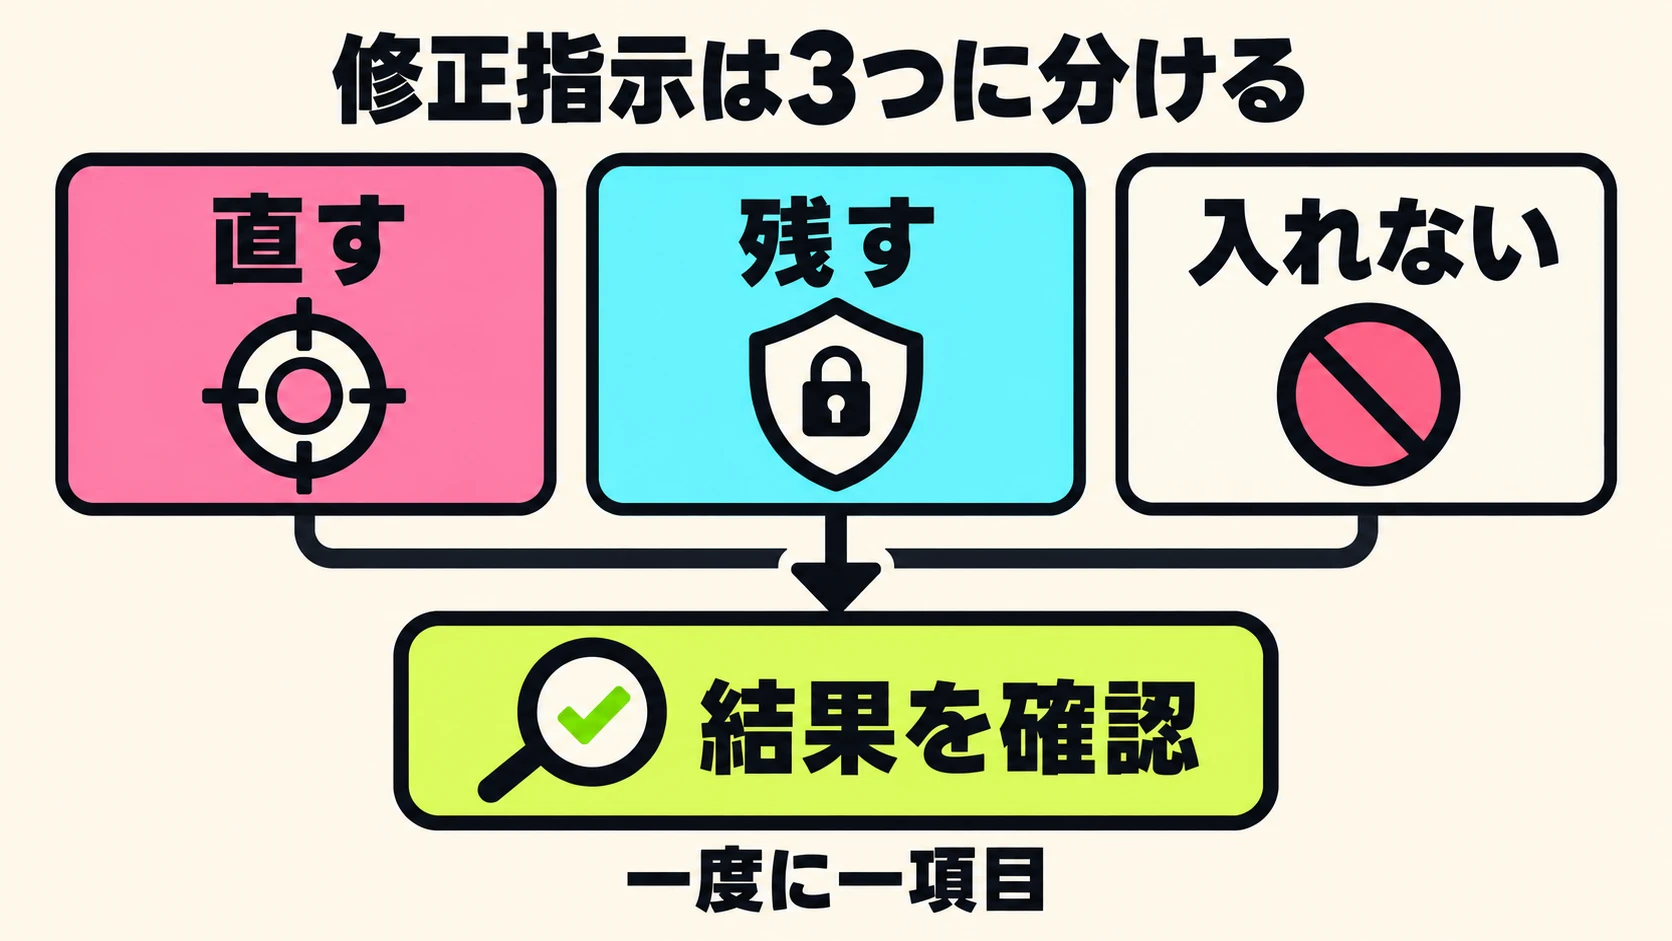
「駄目」ではなく、望む状態を書く
例えば、次の指示では、吹き出しを「どこへ」「誰に向けて」直すのかが分かりません。
吹き出しを左の人物へ向けるのはやめてください。私なら、対象、位置、話している人、向きまで次のように書きます。
今回修正するのは、右上コマにある「条件を増やせば伝わるはずだ」の吹き出しだけです。
このセリフの話者は、右上コマの白峰レンです。
吹き出しの尻尾を、白峰レンの口元へ向けてください。
白峰レンの顔、髪、衣装、姿勢、机、端末、コマ割り、ほかのセリフは現在の画像を維持してください。
人物、吹き出し、説明文字を追加しません。
これで吹き出しが直っても、すぐに採用はしません。顔、髪、衣装、姿勢、机、端末、コマ割り、ほかのセリフが残っているかまで見ます。「吹き出しは直ったけど、顔が変わっている」では、修正完了とは言えないからです。
位置関係は、xとyで補う
「もう少し右」「少し上」でうまく伝わらないときは、xとyで位置を伝えます。例えば、ページの左上をx=0、y=0、右下をx=100、y=100としたときに、動かしたいものがどの付近にあるべきかを数字で示します。
吹き出しの中心を、ページ全体のx=72、y=18付近へ移動してください。
吹き出しの尻尾は、同じコマにいる白峰レンの口元へ向けます。
ページ全体の位置なのか、右上のコマの中だけの位置なのかで、数字の意味は変わります。コマの中を基準にするなら、「右上コマの中をx=0〜100、y=0〜100とする」と、どこからどこまでの数字なのかも一緒に書きます。なお、xとyはあくまで位置を伝えるための数字で、漫画を読む順番とは別です。
コミコ「この吹き出しは駄目」と言うより、どこへ置いて誰へ向けるかまで決めるんですね。
親バカ社長そうです。禁止だけだと、別の外し方をすることがあります。直した後の位置と、残す部分までセットで伝えます。
修正記録は、「直す・維持・禁止・結果」で残す
プロンプトと画像だけを保存していると、後から見返したときに「この修正で、何を直したかったんだっけ?」となります。私はそれを避けるために、生成するたびに次の内容を残しています。
| 記録項目 | 記入する内容 |
|---|---|
| 画像ID | ページ番号と生成番号 |
| 使用した制作指示 | 実際に送ったプロンプト |
| 参照資料 | 三面図、衣装表、表情表、世界観資料など |
| 確認した問題 | 画像上で起きている事実 |
| 今回直す箇所 | 一度の修正で扱う対象 |
| 望む状態 | 修正後にどう見えるべきか |
| 維持する箇所 | 顔、衣装、構図、背景、ほかの文字など |
| 変更禁止 | コマ数、人物数、読む順番など |
| 修正結果 | 直った、別の問題が出た、不採用 |
| 次の対応 | 続けて修正、再生成、新しいセッション |
修正は、後の画像ほど良くなるわけではありません。3回目より1回目の方が良かった、ということもあります。この記録があれば、「どこまで戻るか」を画像と指示の両方から決められます。
3回直らなければ、同じ画像へ指示を足し続けない
私は、同じ問題を3回直しても改善しなければ、その画像への修正はいったん止めます。最初から生成し直すか、新しいセッションへ移ります。
DIAGRAM 03 / THREE-TRY ROUTE
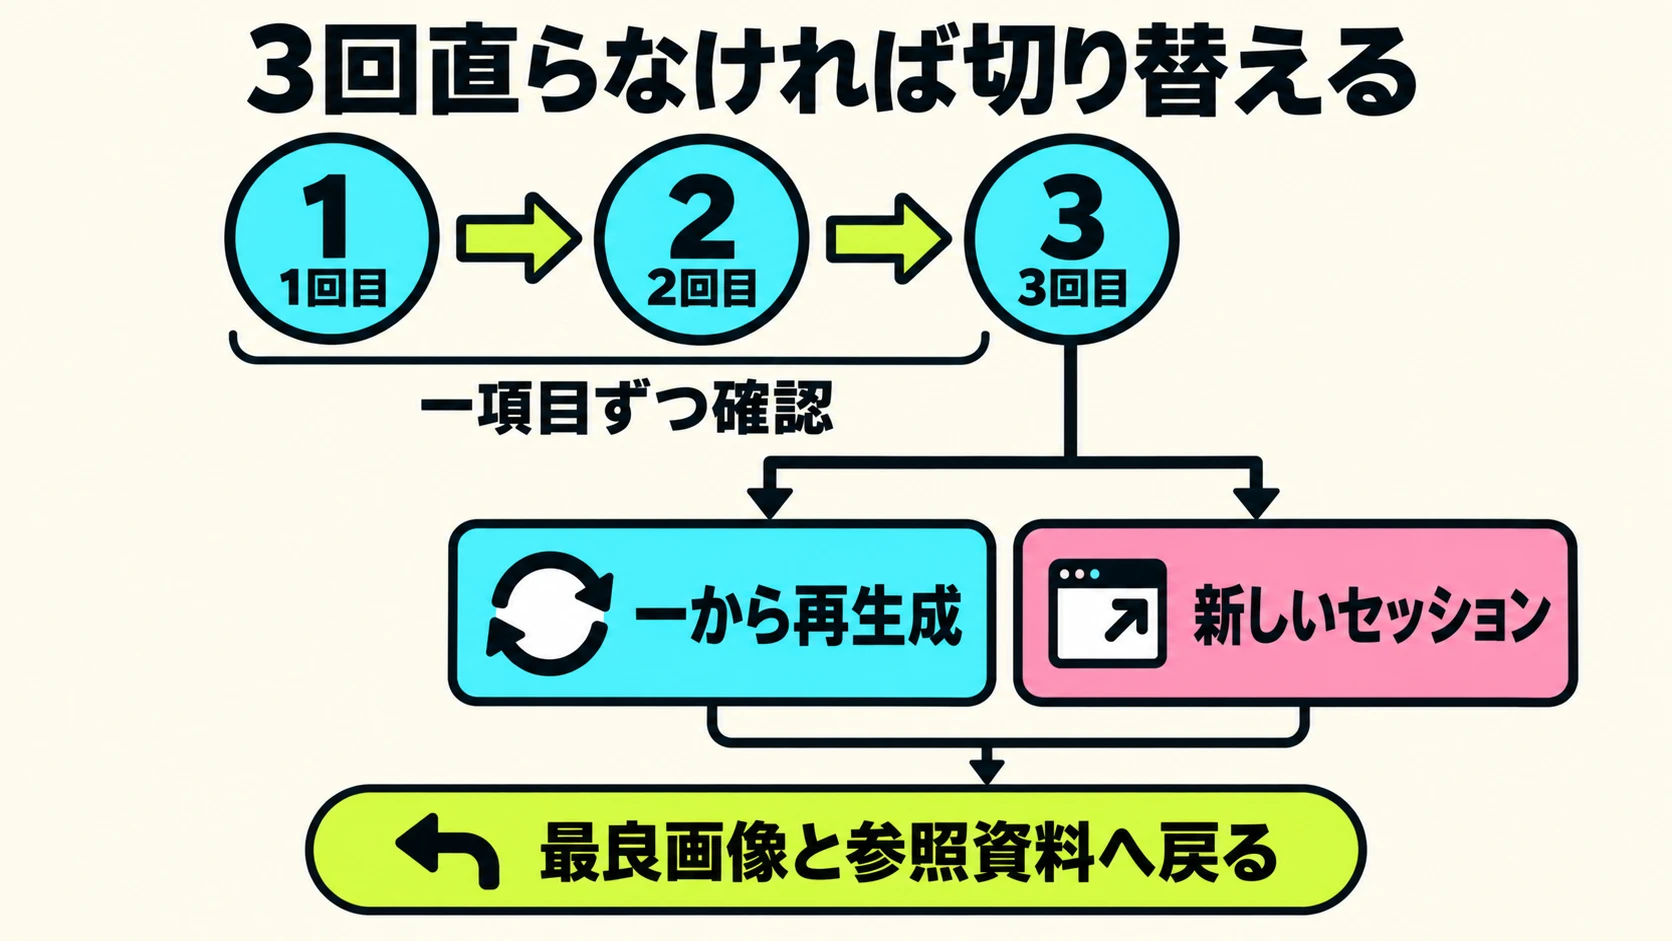
実際には、次の順番で判断しています。
- 現在の画像へ、一項目だけ修正を指示する
- 直らなければ、言葉と位置関係をさらに具体化する
- 3回目まで、毎回結果を確認する
- 3回直らなければ、その画像への修正を打ち切る
- 最初の制作指示と正規の参照資料へ戻り、一から生成する
- 返答や生成結果が不安定なら、新しいセッションへ移る
「あと一回で直るかも」と思って、4回目、5回目の条件を足したくなるんですよね。でも、そこまで来ると、何を直して何を残すのか、自分でも追いにくくなります。3回直しても崩れる画像にさらに指示を積むより、うまくいった条件だけを持って最初から作り直す。その方が結局早いことが多いです。
セッションは、ページ数ではなく制作の状態で分ける
「どこで新しいチャットへ切り替えるの?」という疑問もあると思います。私は、ページ数だけで決めていません。制作物ごとの目安は次の通りです。
| 制作物 | セッションの単位 |
|---|---|
| このコラムのような記事制作 | 1セッションで約3記事分 |
| 漫画 | 原則として1冊で1セッション |
| 漫画動画 | 内容により1〜3セッション |
| 60ページの絵本 | 全ページを目視確認して修正したため3セッション |
| ある程度の完成まで自動化できる制作 | 1セッションで終わることが多い |
ページ数の区切りよりも、ChatGPTとのやり取りが安定しているかを見ています。同じセッションで途中まで進んでいても、次の状態が出たら切り替えます。
- 画像がうまく生成できなくなった
- 返答や生成結果が怪しくなってきた
- 同じミスを繰り返す
- 同じ箇所を3回修正しても直らない
新しいセッションへ移るときは、引き継ぎの文章もAIに書き出してもらいます。正直、「長いな」とは思います(笑)。それでも、文字数を減らすことより、次のセッションで迷わず再開できることを優先しています。残すのは次の内容です。
制作物と現在の工程:
採用済みの画像:
使用する正規の参照資料:
絶対に維持する条件:
現在残っている問題:
すでに試して失敗した修正:
次に行う一項目:
完成確認の条件:
ただ引き継ぎ文を貼るだけでは、前のセッションと完全に同じ状態にはなりません。私は新しいセッションで、正規の人物資料と現在の最良画像をもう一度確認させてから再開します。
AI漫画生成ツールが作るのは、完成品ではなく指示の下書き
「白紙から11項目を埋めるのはちょっと大変」という方のために、サイト内にAI漫画生成ツールを用意しています。主人公や補助人物、外見、作風、色、コマ数、コマ割り、出来事、セリフ、出力サイズなどを選ぶと、1ページ分の制作指示を組み立てられます。顔、文字、吹き出し、コマ割り、身体、絵柄、見切れを直す指示も作れます。
ここは、ツールが作るものと完成した漫画を分けて考えてください。流れは次の3段階です。
- ツールが作るもの:制作指示・修正指示の下書き
- ChatGPTが作るもの:確認と修正が必要な試作画像
- 公開できるもの:人が読み順、文字、人物、身体、権利、掲載条件を確認した画像
ツールで作れるのは、指示の下書きまでです。そのページを何のために作るのか、誰に読んでほしいのか、物語のどこを担うのか、何を絶対に守るのかまでは、あなた自身が決める必要があります。ツールで下書きを作ったら、この記事の制作指示書を見ながら、足りない情報を足してみてください。
まだ「広告に使うのか、漫画LPに使うのか、Kindleに使うのか」が決まっていないなら、先にAI漫画を広告・漫画LP・Kindleのどこで使うかを読んでみてください。使う場所が変われば、1ページの役割も変わります。
公開前は、プロンプトではなく画像そのものを見る
指示をどれだけ丁寧に書いても、公開するのはプロンプトではなく、出来上がった漫画です。だから最後は、実際に掲載する大きさとページ順で画像を見ます。
- コマ数と右から左の読む順番が合っている
- セリフが指定した文言になっている
- 吹き出しの尻尾が話者へ向いている
- スマホで文字を読める
- 人物の顔、髪、衣装、体格が参照資料と合っている
- 同じ場所の机、椅子、窓、時計、棚、照明がつながっている
- 手指、腕の本数、持ち物、家具との前後関係に破綻がない
- 紙の表裏や端末画面の向きが場面と合っている
- ページ端で人物、文字、吹き出しが切れていない
- 参照素材、生成物、公開先の条件を確認した
参照素材や生成物の権利、掲載先の条件をどう確認するかは、AI漫画の著作権と商用利用にまとめました。
まとめ|長さより、何を直して何を残すか
私も最初は、条件を細かく足せば足すほど、頭の中のイメージに近づくと思っていました。実際は、長さよりも「何を分けて書くか」の方が大事でした。
- ページの目的と役割を最初に決める
- 人物資料と世界観資料を必要な一式で渡す
- コマごとに出来事、感情、カメラ位置、セリフを分ける
- 維持するもの、変えてよいもの、入れないものを明記する
- 生成後は現在の最良画像を保存し、一項目ずつ直す
- 3回直らなければ、再生成か新しいセッションへ切り替える
- 最後は人が、実際の画像と公開条件を確認する
プロンプトは、一度貼れば理想の漫画が出てくる呪文ではありません。「作る前に何を決めたか」と「生成後に何を確かめるか」をつなぐ、制作の指示書です。
まずは1ページ分の下書きから作ってみたい方は、AI漫画生成ツールで制作指示を組み立てるところから始めてみてください。人物、作風、コマ数、出来事、セリフを整理したら、この記事の表を見ながら、ページの目的、維持するもの、変えてはいけないものを足していきましょう。
事業で使う漫画は、1ページの絵作りだけでは終わりません。用途、読者、物語、そのページで伝えること、絶対に守るもの、どこまで修正するのかまで決めます。複雑なサービスを伝えたいなら漫画LP制作、これまでの経験や知識を一冊にしたいなら漫画Kindle出版から相談してください。話を聞いた上で、漫画より別の伝え方が合っていると思ったら、無理に漫画を勧めることはありません。
参照した一次情報
- OpenAI Developers「Image prompting」
- OpenAI Developers「Image generation」
公式情報を確認した日は2026年9月24日です。ChatGPTの画像生成や編集機能は変わることがあるので、実際に使うときは最新の公式情報も確かめてください。